PUNTOS CLAVE
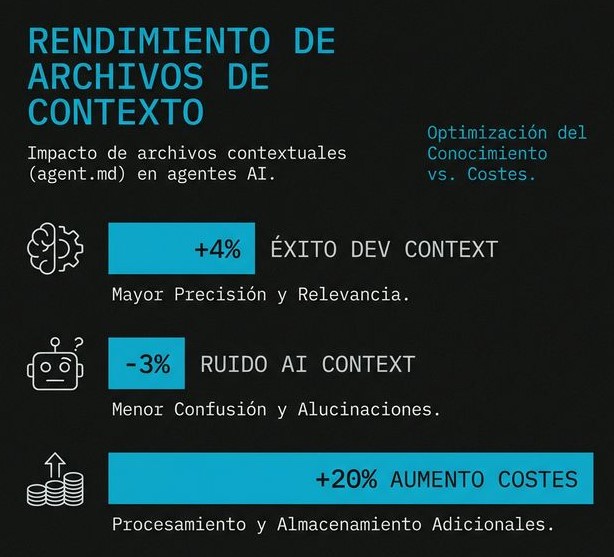
- Los archivos de contexto generados por IA reducen el éxito en un 3% promedio.
- El uso de agent.md aumenta los costes y el tiempo de exploración en un 20%.
- La jerarquía de prompts prioriza las instrucciones del proveedor sobre el archivo local.
- La mejor práctica actual es mantener archivos minimalistas y orientados a corregir errores recurrentes.
En el ecosistema del desarrollo con IA, la gestión de contexto se ha convertido en la nueva frontera. Durante meses, la comunidad ha insistido en que el uso de archivos contextuales en agentes AI, como agent.md o claude.md, es indispensable para que los modelos comprendan nuestra base de código. Sin embargo, estudios recientes sobre el benchmark SWE-bench revelan una realidad incómoda: estos archivos suelen ser más un lastre que una ventaja, disparando los costes de computación sin ofrecer mejoras sustanciales en la resolución de problemas reales.
#La jerarquía invisible del contexto
Para entender por qué estos archivos fallan, debemos comprender cómo «piensa» el modelo. Un agente no solo recibe tu pregunta; recibe una pila de instrucciones jerarquizadas donde el mensaje del desarrollador (tu archivo agent.md) ocupa un lugar intermedio que a menudo genera ruido.
«La parte superior de la jerarquía siempre serán los comportamientos que la empresa entrenó en el modelo. El archivo de contexto es una capa de personalización que a menudo distrae a la IA de su tarea principal.»
#¿Realmente funcionan los archivos .md?
Un estudio detallado comparó tres escenarios: repositorios sin archivos de contexto, repositorios con archivos escritos por expertos y repositorios con archivos autogenerados por la IA. Los resultados sugieren que el esfuerzo de mantenimiento rara vez compensa el resultado.
VARIACIÓN EN LA TASA DE ÉXITO:
Sin archivo (Base)    ████████████████ 100%
Escrito por humano    █████████████████ (+4%)
Generado por IA       ███████████████ (-3%)

AUMENTO DE COSTES OPERATIVOS:
Exploración y Tokens  ████████████████████ (+20%)
El dato más alarmante es que el uso de estos archivos incrementa los costes y el tiempo de exploración en un 20%. La IA gasta más tiempo procesando instrucciones redundantes que ejecutando cambios efectivos en el código.
#El efecto del «Elefante Rosa» y el sesgo tecnológico
Incluir demasiada información en un claude.md puede ser contraproducente. Si mencionas que tu proyecto usa TRPC para legacy pero se está moviendo a Convex, la IA desarrollará un sesgo hacia TRPC simplemente por haberlo leído en el contexto primario. Es el clásico problema de «no pienses en un elefante rosa»: al dárselo como instrucción, el modelo ya lo tiene en su buffer de autocompletado.
#Cuándo usar (y cuándo NO usar) archivos de contexto
#Usar si:
- Existen patrones anti-IA específicos en tu código que el modelo no puede deducir solo.
- Necesitas forzar un comportamiento de seguridad o flujo de trabajo único (ej. nunca ejecutar un comando específico).
- El modelo comete sistemáticamente el mismo error tras múltiples intentos.
#No usar si:
- La información ya está en el package.json o en el README.md.
- El archivo fue generado por un comando automático de
/initsin revisión humana. - No tienes capacidad para mantener el archivo sincronizado con los cambios de arquitectura.
#Pros y Contras de la Gestión Contextual
| Aspecto | Ventaja | Desventaja |
|---|---|---|
| Precisión Técnica | Guía en APIs propietarias raras. | Sesgo hacia tecnologías obsoletas. |
| Eficiencia | Menos preguntas iniciales. | Aumento del 20% en consumo de tokens. |
| Consistencia | Mantiene el estilo de código. | Limita la capacidad de razonamiento creativo. |
#Micro-Historia: El caso del endpoint fantasma
Hace unos meses, mientras trabajaba en Lawn (una plataforma de revisión de vídeo), noté que mi agente insistía en usar tipos de datos antiguos para el pipeline de procesamiento. No importaba cuántas veces le pasara el esquema de la base de datos; el agente seguía fallando.
Tras una hora de frustración, revisé el claude.md que había generado automáticamente semanas atrás. Allí estaba: una descripción detallada de cómo «solía» funcionar el almacenamiento de vídeos. Al eliminar el archivo de contexto, el agente realizó una búsqueda fresca en el directorio /convex y resolvió el problema en menos de dos minutos. El archivo de contexto estaba actuando como un «anteojera» que le impedía ver la realidad del código actual.
// El error inducido por el agent.md obsoleto
export const processOldVideo = internalAction({
  args: { videoId: v.id("videos") }, // El agent.md decía que esto era obligatorio
  handler: async (ctx, args) => {
    // Lógica que ya no existía en el servidor
  },
});

// Lo que el agente encontró tras borrar el archivo
export const processVideo = internalAction({
  args: { storageId: v.string() }, // Nuevo patrón detectado vía exploración
  handler: async (ctx, args) => {
    // Implementación correcta basada en el código real
  },
});En conclusión, el secreto de una buena ingeniería de agentes no es darles más información, sino darles la información correcta en el momento justo. Menos documentos significa menos distracciones, menos costes y, curiosamente, un código mejor ejecutado.
| Métrica de Impacto | Valor Registrado |
|---|---|
| Mejora en archivos dev-written | +4% |
| Pérdida en archivos LLM-generated | -3% |
| Sobrecoste de tokens | 20% |
| Prioridad de prompt | Baja (Sustituible por exploración) |
Fuentes oficiales: SWE-bench Results | Anthropic Context Best Practices